 cho.sh
트리 편집 거리
아직 제출이 없습니다시간 제한2초메모리 제한256 MB문제
XML 문서는 계층 구조 데이터를 담기 때문에 보통 순서 있는 라벨 트리로 모델링한다. 트리의 정점 하나는 XML 요소 하나에 대응하고, 정점의 라벨은 그 요소의 태그 이름이다. 간선 하나는 부모 요소와 자식 요소의 관계를 나타낸다. 두 XML 문서가 구조적으로 얼마나 비슷한지 재는 일은 정보 검색에서 자주 다루는 문제다. 여기서는 순서 있는 라벨 트리로 표현한 두 XML 문서의 구조적 유사도를 구한다.
정점이 하나 이상인 루트 트리를 라고 하자. 모든 정점에 라벨이 붙어 있으면 를 라벨 트리라고 한다. 라벨은 서로 같아도 된다. 모든 정점에서 자식 사이에 왼쪽부터 오른쪽으로 가는 순서가 정해져 있으면 를 순서 트리라고 한다.
순서 있는 라벨 트리 과 의 유사도는 흔히 트리 편집 거리 로 잰다. 는 을 로 바꾸는 편집 연산의 최소 횟수다. 트리 에 적용할 수 있는 편집 연산은 다음 세 가지다.
- : 라벨이 인 잎 정점 하나를 넣는다. 연산 전에 부모의 자식이 개였다면, 새 정점은 인 어떤 에 대해 부모의 번째 자식이 된다.
- : 잎 정점 하나를 지운다. 정점이 하나뿐인 트리에는 이 연산을 적용할 수 없다.
- : 어떤 정점의 라벨 를 라벨 로 바꾼다.
연산 한 번이 넣거나 지우거나 라벨을 바꾸는 정점은 정확히 하나다.
그림 1의 두 트리를 보자. 의 잎 정점 C에 를 적용하고, 이어서 와 를 적용하면 이 로 바뀐다. 연산을 두 번 이하로 써서는 을 로 바꿀 수 없다. 따라서 는 3이다.
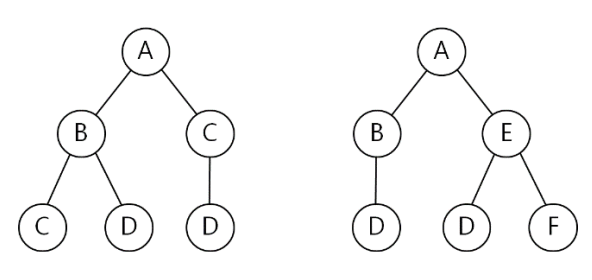
(a) (b)
그림 1. 순서 있는 라벨 트리 두 개
주어진 순서 있는 라벨 트리 두 개의 트리 편집 거리를 구하는 프로그램을 작성하라.
입력
첫째 줄에 테스트 케이스의 개수 가 주어진다. 각 테스트 케이스는 두 줄로 이루어진다. 첫째 줄에 의 표현이, 둘째 줄에 의 표현이 주어진다.
트리의 표현 방식은 다음과 같다. 라벨이 인 루트 정점 하나로만 이루어진 트리는 로 적는다. 루트의 라벨이 이고 부분 트리가 왼쪽부터 차례로 인 트리는 로 적는다. 여기서 는 각각 의 표현이다.
정점의 라벨은 모두 영어 대문자 한 글자다. 표현에는 공백이 없고, 각 트리의 정점 개수는 1 이상 1,000 이하다.
출력
각 테스트 케이스마다 을 로 바꾸는 편집 연산의 최소 횟수를 한 줄에 출력한다.