 cho.sh
힐베르트 정렬
격자 위 최대 200,000개 지점을 힐베르트 곡선이 방문하는 순서대로 정렬해 식별자를 출력합니다.
보통6재귀정렬기하아직 제출이 없습니다시간 제한5초메모리 제한256 MB문제
데이터베이스 저장소에서 항목을 수치 키 순서로 배열하면 원하는 항목을 찾기 쉬워지고 CPU 캐시도 더 잘 쓴다. 메모리에서 연속한 구간이 서로 비슷한 키의 항목을 담기 때문이다. 키가 어떤 구간에 들어가는 항목을 모두 읽을 때 이런 배치가 도움이 된다.
키가 2차원 격자 위의 점이면 이야기가 복잡해진다. GPS 길안내 시스템이 그런 경우다. 점 를 로 먼저 정렬하고 가 같을 때만 로 정렬하면, 메모리에서 이웃한 두 점은 는 비슷해도 는 크게 다를 수 있어서 격자 위에서는 멀리 떨어진다. 거리를 더 잘 보존하려면 연속인 공간 채움 곡선을 따라 데이터를 정렬하면 된다.
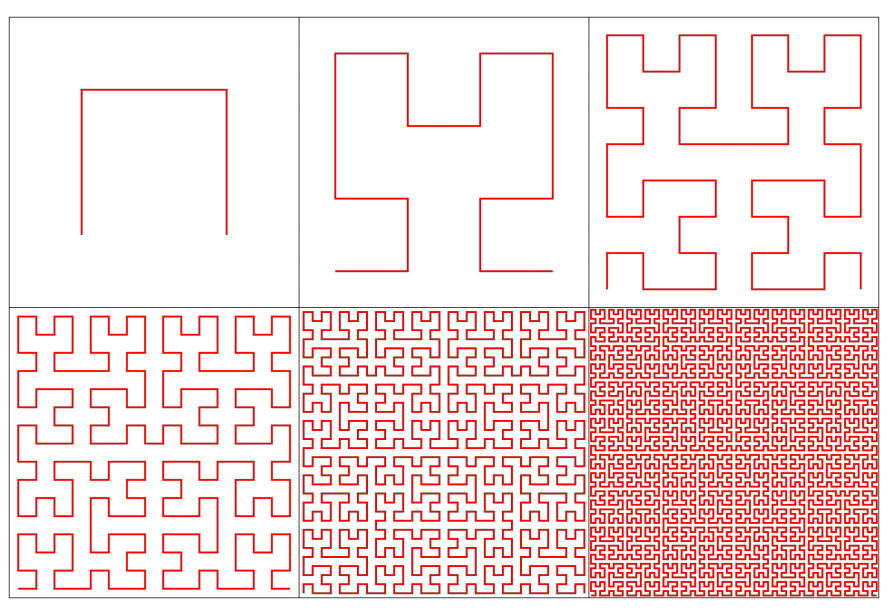
여기서는 공간 채움 곡선 가운데 힐베르트 곡선을 쓴다. 힐베르트 곡선은 원점 에서 시작해 에서 끝나고, 그 사이에 과 를 두 꼭짓점으로 하는 축에 평행한 정사각형 전체를 지난다. 만드는 방법은 재귀적이다. 정사각형을 에서 만나는 네 개의 사분면으로 나눈 다음, 각 사분면을 알맞게 회전하고 축소한 힐베르트 곡선 전체의 복사본으로 채운다. 첫째로 왼쪽 아래 사분면은 에서 로 가는 곡선으로 채운다. 둘째로 왼쪽 위 사분면은 에서 까지 채운다. 셋째로 오른쪽 위 사분면은 에서 까지 채운다. 마지막으로 오른쪽 아래 사분면은 에서 까지 채운다. 힐베르트 곡선은 곡선 열의 극한으로 정의할 수도 있다. 그림은 그 열의 처음 여섯 개다.
관심 지점의 위치가 주어진다. 힐베르트 곡선이 지나는 순서대로 지점을 정렬하라. 이 곡선은 를 비롯해 무한히 많은 곳에서 자기 자신과 만나지만, 가 홀수이므로 모든 정수 점은 정확히 한 번만 지난다.
입력
첫째 줄에 정수 과 가 공백으로 구분되어 주어진다 (, , 는 홀수). 다음 개 줄에는 관심 지점이 한 줄에 하나씩 주어진다. 번째 줄은 정수 와 (), 그리고 식별자 문자열로 이루어지고 각 값은 공백으로 구분된다. 식별자는 길이가 46 이하이고 영문 대문자, 소문자, 숫자로만 이루어진다. 위치가 같은 지점은 없고, 식별자가 같은 지점도 없다.
출력
개의 식별자를 힐베르트 곡선이 각 지점을 지나는 순서대로 한 줄에 하나씩 출력한다.