Non-Maximum Suppression
시간 제한20초메모리 제한256 MB
크기가 같고 점수가 서로 다른 정사각형들이 주어질 때, 남은 것 중 점수가 가장 높은 것을 고르고 그와의 IoU가 임계값을 넘는 것을 제거하는 과정을 반복한 뒤 선택된 상자 번호를 오름차순으로 출력한다.
문제
Non-maximum suppression (NMS) 는 컴퓨터 비전의 여러 분야에서 널리 쓰이며, 많은 객체 검출 알고리즘의 필수 구성 요소다. 객체 검출에서 흔히 겪는 문제 중 하나는 하나의 객체가 여러 번 검출될 수 있다는 것이다. NMS 기법은 객체마다 단 하나의 검출만 남도록 보장한다.
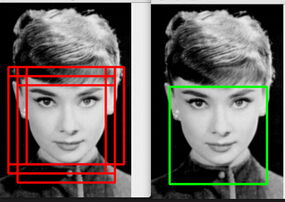
알고리즘은 각 클래스마다 바운딩 박스 목록을 제안한다. 각 박스에는 점수가 붙는데, 이 점수는 박스 안에 해당 클래스의 객체가 있다고 알고리즘이 판단하는 신뢰도를 나타낸다. 이제 NMS 절차가 어떻게 동작하는지 보자. 처음에는 모든 박스가 선택되지 않았고 억제되지도 않았다.
- 먼저, 선택되지 않았고 억제되지도 않은 박스 중에서 신뢰도 점수가 가장 높은 박스를 선택한다.
- 그다음, 이미지에서 선택되지 않은 모든 박스를 살펴본다. 선택되지 않은 박스와 선택된 박스의 IoU 가 주어진 임곗값보다 엄격히 크면, 그 선택되지 않은 박스는 억제된다(버려진다). 두 박스가 얼마나 겹치는지는 Intersection over Union (IoU) 개념으로 측정한다.
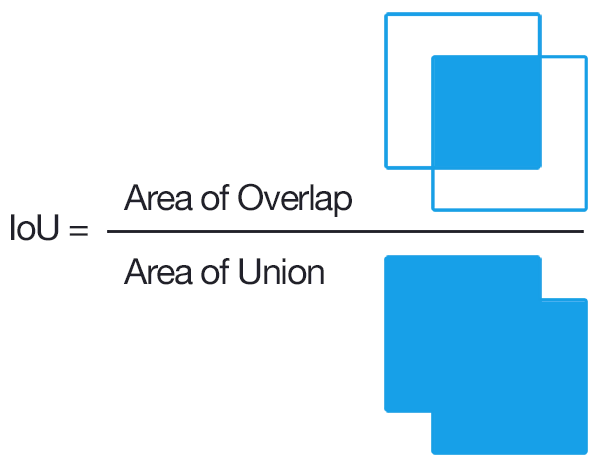
- 억제되지 않은 박스가 모두 선택될 때까지 위 절차를 반복한다.
이 문제에서는 클래스가 하나뿐이라고 가정하고, 객체 검출 알고리즘을 단순화하여 정사각형 모양의 같은 크기 박스만 제안한다. IoU 임곗값과 알고리즘이 제안한 합동인 정사각형 박스 목록이 주어질 때, NMS 절차를 거친 뒤 선택된 모든 박스를 보고할 수 있는가?
입력
입력의 첫 줄에는 테스트 케이스의 수 ()가 주어진다. 그다음 개의 테스트 케이스가 이어진다.
각 테스트 케이스의 첫 줄에는 정수 두 개 , (, )와 실수 ()가 주어진다. 이는 검출 알고리즘이 제안한 정사각형 바운딩 박스의 개수, 정사각형의 크기, IoU 임곗값을 나타낸다. 는 정확한 값이며 소수점 아래 세 자리까지 주어진다.
다음 줄에는 각 줄마다 정수 두 개 , (, )가 주어진다. 이는 정사각형 박스의 왼쪽 아래 모서리 좌표이며, 이어서 실수 ()가 주어진다. 이는 이 박스의 점수다. 점수는 정확한 값이며 소수점 아래 여섯 자리 이하를 가진다. 또한 점수는 모두 다르다.
출력
각 테스트 케이스마다 출력은 "Case #x: y" 를 담은 줄로 시작한다. 여기서 x 는 테스트 케이스 번호(1부터 시작)이고, y 는 NMS 절차를 거친 뒤 선택된 바운딩 박스의 개수다. 다음 줄에는 박스의 인덱스(1부터 시작)를 오름차순으로 나타내는 y 개의 정수가 주어진다.
힌트
예제에는 개의 박스 , , 가 있으며, 이미 점수 내림차순으로 정렬되어 있다. 두 번째 박스는 첫 번째 박스와의 IoU가 로 IoU 임곗값 보다 엄격히 크기 때문에 억제된다. 세 번째 박스는 첫 번째 박스와의 IoU가 로 IoU 임곗값보다 작기 때문에 선택된다.