 cho.sh
Over Fitting (Small)
LOVELYZ인 점과 아닌 점이 주어질 때, 한쪽 열린 반평면에 LOVELYZ 점만 들어가도록 직선을 놓고 그 안에 담을 수 있는 LOVELYZ 점의 최대 개수를 구한다.
보통7기하완전 탐색정렬수학아직 제출이 없습니다시간 제한1초메모리 제한512 MB문제
요즘은 바야흐로 빅데이터 전성시대다. 너도나도 머신러닝과 데이터 사이언스를 배우려고 애쓰고 있다. 데이터 마이닝과 머신러닝을 급하게 공부한 동이는 배운 내용을 바탕으로 주어진 데이터를 분류하는 선형 분류기(Linear Classifier)를 찾는 알고리즘을 설계하려고 한다.
선형 분류기는 쉽게 말해 데이터가 가진 두 특징값 로 데이터의 유형을 올바르게 분류하는 직선의 방정식이다. 주어진 데이터에서 이런 방정식 가운데 최적의 방정식을 자동으로 찾으려고 수많은 알고리즘이 개발되었다.
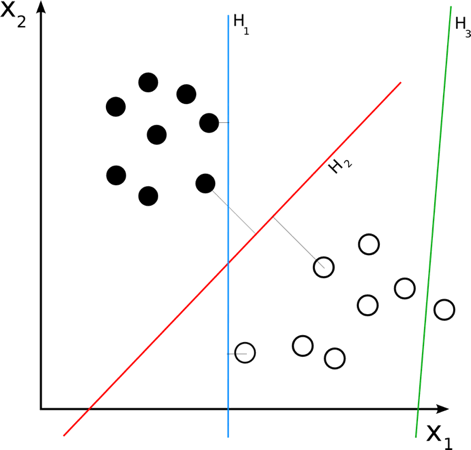
위의 데이터는 선형 분류기로 두 그룹으로 정확히 나눌 수 있다.
위의 예시를 보자. 직선 H1과 H2는 두 특징 과 로 흰 그룹과 검은 그룹을 완전히 나누므로 좋은 분류기다. 반면 H3은 두 그룹을 나누지 못하므로 좋은 분류기가 아니다.
하지만 이렇게 정확하게 분류하는 선형 분류기가 항상 존재하지는 않는다. 현실의 데이터에는 예외와 오차가 많은데 선형 분류기는 너무 단순하기 때문이다.
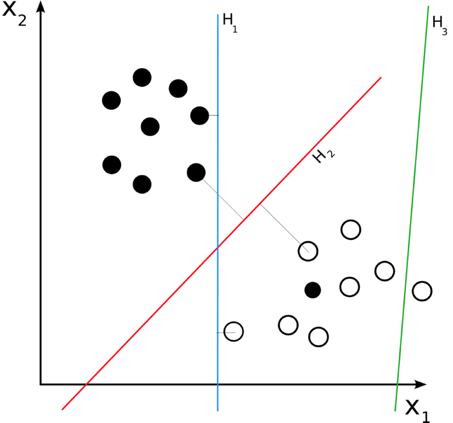
동이는 명의 사람을 나타내는 두 특징값과 각 사람이 가장 좋아하는 걸그룹 정보를 수집했다. 동이는 이 두 특징값으로 러블리즈를 가장 좋아하는 사람을 분류하는 선형 분류기를 찾으려 한다. 동이가 찾는 선형 분류기는 다음 조건을 만족해야 한다.
- 선형 분류기는 특징값에 따라 데이터를 두 그룹(Positive, Negative)으로 나눈다.
- 직선을 기준으로 어느 쪽을 Positive로, 어느 쪽을 Negative로 정할지는 마음대로 정할 수 있다.
- Positive 그룹에는 러블리즈를 가장 좋아한다고 답한 사람만 들어가야 한다.
- Negative 그룹에 속한 사람 가운데 러블리즈를 가장 좋아한다고 답한 사람이 적을수록 좋은 선형 분류기다.
동이는 여러 알고리즘을 도입해 컴퓨터가 최적의 선형 분류기를 자동으로 찾게 할 계획이었다. 그런데 그 전에 자신의 데이터에서 위 조건을 만족하는 최적의 선형 분류기가 이론적으로 어느 정도의 성능을 내는지 궁금해졌다. 그 값을 알아야 동이의 프로그램이 찾은 선형 분류기와 비교해서 성능을 평가할 수 있기 때문이다.
동이가 선형 분류기를 만드는 데 쓸 데이터가 주어질 때, 위 조건을 만족하는 가장 좋은 선형 분류기가 러블리즈를 가장 좋아하는 사람 중 몇 명을 Positive 그룹으로 분류할 수 있는지 구하는 프로그램을 작성하시오.
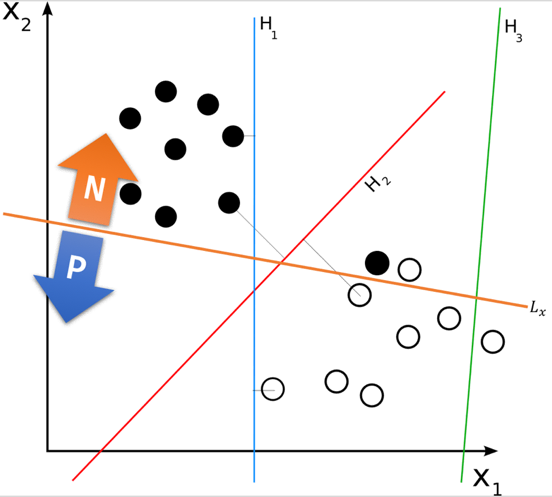
흰 점을 Positive에 가장 많이 포함하는 선형 분류기는 L이다.
위의 예시를 보자. 흰 점은 러블리즈를 가장 좋아한다고 답한 사람이고, 검은 점은 다른 그룹을 가장 좋아한다고 답한 사람이다. Positive에 흰 점을 가장 많이 포함하는 선형 분류기가 가장 좋은 분류기이므로 직선 L을 긋고 아래쪽을 Positive, 위쪽을 Negative로 정하면 가장 좋은 선형 분류기가 된다. 이때 답은 7이다.
입력
첫째 줄에 응답 데이터의 수를 나타내는 자연수 ()이 주어진다. 다음 개의 줄에는 한 사람의 데이터가 x1 x2 NAME 형식으로 주어진다 (, NAME의 길이는 1 이상 15 이하). 과 는 그 사람의 특징을 나타내는 두 정수다. NAME은 그 사람이 가장 좋아하는 걸그룹의 이름이며 공백 없이 알파벳 대문자로 주어진다.
러블리즈를 가장 좋아한다고 답한 사람의 그룹 이름은 항상 LOVELYZ이다. 러블리즈를 가장 좋아하는 사람과 그렇지 않은 사람은 각각 3명 이상이다.
각 사람의 특징값을 좌표로 삼아 2차원 평면 위에 점으로 나타냈을 때 세 개 이상의 점이 한 직선 위에 놓이는 경우는 없다.
출력
최적의 선형 분류기가 Positive로 분류할 수 있는 러블리즈를 가장 좋아하는 사람의 수를 한 줄에 출력한다. 그런 사람을 한 명도 Positive로 분류할 수 없으면 0을 출력한다.