 cho.sh
오버피팅 (Large)
평면 위 N개의 점이 LOVELYZ인지 아닌지로 표시되어 있을 때, 양의 반평면에 LOVELYZ가 아닌 점을 하나도 넣지 않으면서 LOVELYZ 점을 최대로 담는 직선을 찾는다.
어려움8기하정렬이분 탐색투 포인터아직 제출이 없습니다시간 제한3초메모리 제한512 MB문제
빅데이터가 한창 유행이다. 너도나도 머신러닝과 데이터사이언스를 배우려고 한다. 데이터마이닝과 머신러닝을 급하게 공부한 동이는 배운 내용을 바탕으로 주어진 데이터를 분류하는 선형 분류기(linear classifier)를 찾는 알고리즘을 설계하려 한다.
선형 분류기는 데이터가 가진 두 특징값 , 로 데이터의 유형을 올바르게 나누는 직선의 방정식이다. 주어진 데이터에서 이런 직선 중 최적의 직선을 자동으로 찾으려고 수많은 알고리즘이 개발되었다.
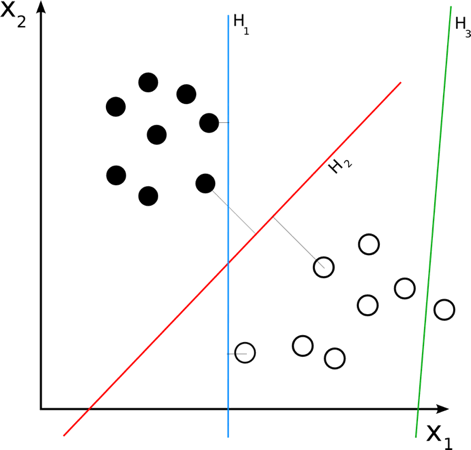
위 데이터는 선형 분류기로 두 그룹을 정확히 나눌 수 있다.
직선 과 는 두 특징 과 로 흰 그룹과 검은 그룹을 완전히 나누므로 좋은 분류기다. 반면 은 직선 하나로 두 그룹을 나누지 못하므로 좋은 분류기가 아니다.
그러나 이렇게 정확히 나누는 선형 분류기가 항상 있지는 않다. 현실의 데이터에는 예외와 오차가 많고, 그에 비해 선형 분류기는 너무 단순하다.
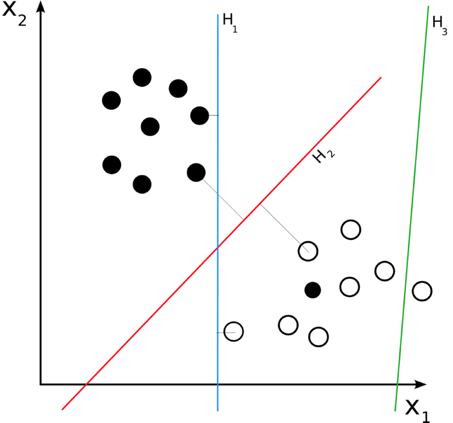
동이는 사람 명의 특징값 두 개와 각자 가장 좋아하는 걸그룹을 조사했다. 이 자료로 러블리즈를 가장 좋아하는 사람을 가려내는 선형 분류기를 찾으려 한다. 동이가 찾는 선형 분류기는 다음 조건을 만족해야 한다.
- 선형 분류기는 특징값을 바탕으로 데이터를 Positive와 Negative 두 그룹으로 나눈다.
- 직선을 기준으로 어느 쪽을 Positive로 하고 어느 쪽을 Negative로 할지는 마음대로 정할 수 있다.
- Positive 그룹에는 러블리즈가 가장 좋다고 답한 사람만 들어가야 한다.
- Negative 그룹에 속한 러블리즈 응답자가 적을수록 좋은 선형 분류기다.
동이는 여러 알고리즘을 써서 컴퓨터가 최적의 선형 분류기를 자동으로 찾아내게 할 예정이었다. 그전에 자기가 가진 데이터에서 위 조건을 만족하는 최적의 선형 분류기가 이론적으로 어느 정도 성능을 내는지 궁금해졌다. 그래야 프로그램이 찾아낸 선형 분류기와 견주어 성능을 평가할 수 있기 때문이다.
동이가 선형 분류기를 만드는 데 쓸 데이터가 주어질 때, 위 조건을 만족하는 가장 좋은 선형 분류기가 러블리즈를 가장 좋아하는 사람 중 몇 명을 Positive 그룹으로 분류하는지 구하는 프로그램을 작성하자.
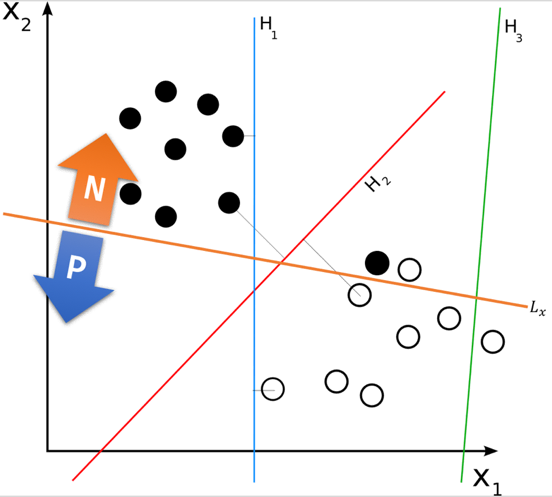
흰 점을 Positive에 가장 많이 넣는 선형 분류기는 이다.
위 그림에서 흰 점은 러블리즈가 가장 좋다고 답한 사람이고, 검은 점은 다른 그룹을 고른 사람이다. Positive에 흰 점을 가장 많이 넣는 분류기가 가장 좋은 분류기이므로, 직선 을 잡고 아래쪽을 Positive, 위쪽을 Negative로 정하면 가장 좋은 선형 분류기가 된다. 이때 답은 7이다.
입력
첫 줄에 응답 데이터의 수 ()이 주어진다. 이어지는 개 줄에 x1 x2 NAME 형식으로 데이터가 주어진다 (, NAME의 길이는 1 이상 15 이하). 과 는 각각 그 사람의 특징을 나타내는 정수이고, 그룹 이름은 공백 없이 알파벳 대문자로 주어진다.
러블리즈를 가장 좋아한다고 답한 사람은 그룹 이름이 항상 LOVELYZ다. 러블리즈를 가장 좋아하는 사람과 그렇지 않은 사람은 각각 최소 3명씩 있다.
각 사람의 특징을 좌표로 삼아 2차원 평면에 데이터를 나타냈을 때 세 점 이상이 한 직선 위에 놓이는 경우는 없다.
출력
최적의 선형 분류기가 러블리즈를 가장 좋아하는 사람 중 Positive로 분류하는 사람 수를 한 줄에 출력한다.