 cho.sh
흐름 그래프 복잡도
S, B(...), L(...)로 이루어진 흐름 그래프 문자열을 해석해 순방향 간선, 역방향 간선, 노드 수를 세고 |EF| + W*|EB| - |V| + 2를 출력하며, 형식이 틀리면 -1을 출력한다.
보통6문자열구현스택재귀아직 제출이 없습니다시간 제한1초메모리 제한512 MB문제
수환은 프로그램 복잡도 국제 위원회(ICPC)를 이끌고 있다. ICPC가 하는 주된 일은 프로그램 코드의 복잡도를 재는 것이다. 프로그램을 나타내는 잘 알려진 방법으로 제어 흐름 그래프가 있다. 정점은 프로그램의 구성 요소를, 간선은 제어가 흘러갈 수 있는 경로를 나타낸다. 흐름 그래프의 복잡도를 재는 방법으로는 순환 복잡도가 널리 쓰인다. 흐름 그래프를 나타내는 유향 그래프 의 순환 복잡도는 로 정의한다. 예를 들어 그림 C.1의 흐름 그래프 과 는 둘 다 복잡도가 3이다().
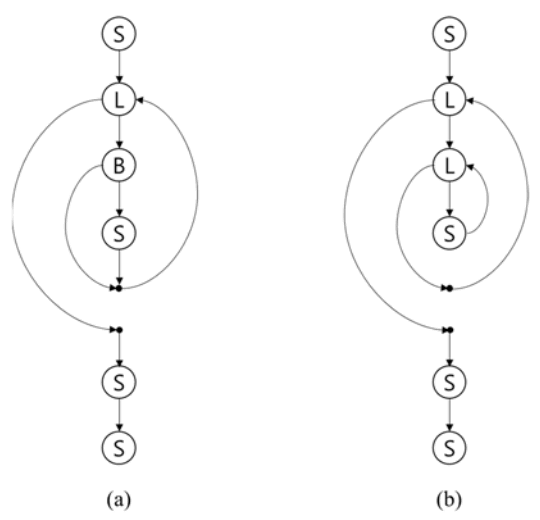
그림 C.1: 흐름 그래프 (a)과 (b)
그림 C.1에서 B, L, S는 정점의 종류를 나타낸다. B는 분기, L은 반복, S는 단순 명령문이다. 분기 정점 B는 명령문을 하나 이상 건너뛰는 전방 간선을 하나 더 만든다. 반복 정점 L은 들어오는 후방 간선의 목적지이면서, 반복을 빠져나가는 전방 간선도 만든다. 반복문이나 분기문이 닫히는 지점을 찍은 점도 정점이다.
순환 복잡도에는 반복문이 만드는 후방 간선을 전방 간선과 똑같은 가중치로 세는 점이 문제라는 지적이 있다. 그래서 수환은 후방 간선에 더 큰 가중치를 주는 새 척도를 고안했다. 간선을 전방 간선의 집합 와 후방 간선의 집합 로 나누고(이고 ), 후방 간선의 가중치를 상수 라 할 때 흐름 그래프 복잡도라는 새 척도를 로 정의했다. 수환은 이 새 척도가 쓸 만한지 확인하려고 한다.
흐름 그래프가 주어지면 새 복잡도를 계산하는 프로그램을 만들어 수환을 도와주자. 문제를 간단히 하려고 선검사 반복문(C의 while 문)과 단방향 분기문(else 절이 없는 if 문)만 나온다고 가정한다. 이 가정 아래에서 흐름 그래프는 정점 종류를 늘어놓은 문자열로 나타낼 수 있다.
- L은 반복 정점,
- B는 분기 정점,
- S는 단순 명령문 정점이다.
L과 B 뒤에는 그 하위 구조를 나타내는 문자열이 괄호 한 쌍으로 묶여 따라온다. 닫는 지점은 괄호로 대신 표현한다. 정점 표현이 여럿 이어질 때는 쉼표로 구분한다. 이 표기를 따르면 그림 C.1의 두 그래프는 다음과 같이 적는다.
- : S,L(B(S)),S,S
- : S,L(L(S)),S,S
일 때 새 복잡도는 , 이다.
문자열이 나타내는 그래프를 정확히 적으면 다음과 같다. S는 정점 하나이고, 그 정점이 입구이자 출구다. 하위 구조가 X인 분기 B는 분기 정점과 닫는 정점으로 이루어진다. 간선은 분기 정점에서 X의 입구로 가는 전방 간선, X의 출구에서 닫는 정점으로 가는 전방 간선, 분기 정점에서 닫는 정점으로 가는 전방 간선 이렇게 셋이다. 입구는 분기 정점이고 출구는 닫는 정점이다. 하위 구조가 X인 반복 L도 반복 정점과 닫는 정점으로 이루어진다. 간선은 반복 정점에서 X의 입구로 가는 전방 간선, X의 출구에서 닫는 정점으로 가는 전방 간선, 닫는 정점에서 반복 정점으로 가는 후방 간선 이렇게 셋이다. 입구와 출구가 모두 반복 정점이므로 반복을 빠져나가는 전방 간선은 반복 정점에서 시작한다. 항목이 쉼표로 이어지면 앞 항목의 출구에서 다음 항목의 입구로 전방 간선이 하나 생긴다. 프로그램 전체에 따로 시작 정점이나 끝 정점을 두지는 않는다.
입력
입력은 표준 입력으로 받는다. 첫 줄에 후방 간선의 가중치인 정수 가 주어진다(). 다음 줄에 흐름 그래프의 문자열 표현 가 주어진다. 의 길이는 70,000보다 작다. 는 대문자와 문장 부호로 이루어진다. 읽기 편하도록 에 공백이 섞일 수 있고, 공백은 무시한다. 소괄호 쌍 대신 대괄호 쌍 [와 ]를 쓸 수 있으며, 여는 기호와 닫는 기호의 종류는 서로 맞아야 한다. 에 콜론(:), 세미콜론(;), 마침표(.) 같은 다른 문장 부호가 잘못 들어올 수 있고, 프로그램은 이를 잘못된 기호로 판별해야 한다. 다음 중 하나라도 해당하면 는 잘못된 문자열이다. (1) 소괄호와 대괄호의 짝이 맞지 않는다. (2) 소괄호, 대괄호, 쉼표가 아닌 문장 부호가 들어 있다. (3) S,,S나 SS, B,(S)처럼 문장 부호가 잘못 붙거나 빠졌다. (4) S, L, B가 아닌 정점 종류가 들어 있다. 올바른 그래프에는 정점이 적어도 하나 있다.
출력
표준 출력으로 한 줄을 출력한다. 가 나타내는 그래프 의 흐름 그래프 복잡도 를 적는다. 가 잘못된 문자열이면 대신 -1을 출력한다.