 cho.sh
트리와 쿼리
뿌리 없는 트리와 루트 R이 주어질 때, 각 질의 정점을 루트로 하는 서브트리의 정점 수를 구한다.
보통4트리DFS그래프재귀아직 제출이 없습니다시간 제한1초메모리 제한128 MB문제
간선에 가중치와 방향이 없는 임의의 루트 있는 트리가 주어진다. 아래 쿼리에 답해 보자.
- 정점 를 루트로 하는 서브트리에 속한 정점의 수를 출력한다.
문제를 푸는 데 어려움이 있다면 아래 힌트에 실린 설명을 참고하자.
입력
첫째 줄에 트리의 정점 수 , 루트의 번호 , 쿼리의 수 가 주어진다. (, , )
이어지는 개 줄에 형태로 트리에 속한 간선의 정보가 주어진다. (, )
이는 와 를 양 끝점으로 하는 간선이 트리에 속한다는 뜻이다.
이어지는 개 줄에 문제에서 설명한 가 하나씩 주어진다. ()
입력으로 주어지는 트리는 항상 올바른 트리임이 보장된다.
출력
개 줄에 걸쳐 각 쿼리의 답을 정수 하나로 출력한다.
힌트
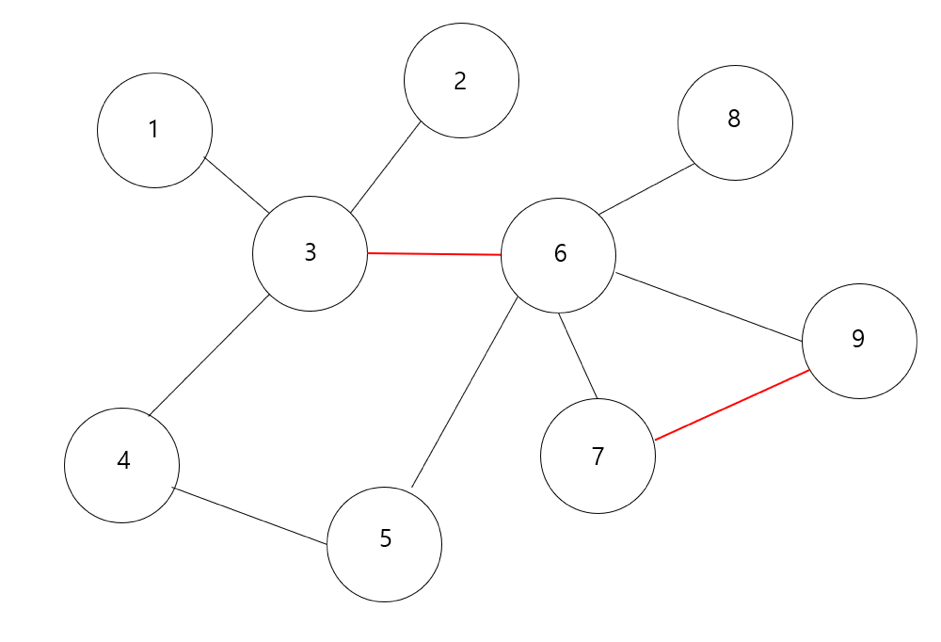
그래프는 정점과, 정점 둘을 잇는 간선으로 이루어진 집합이다.
위 그림은 정점 9개(원 모양)와 간선 10개(실선)로 이루어진 그래프다. 각 원 안에 쓰인 숫자는 편의상 정점에 매긴 번호다.
붉은 간선은 뒤의 설명을 위해 미리 색칠해 둔 것이니, 우선은 다른 검은 간선과 같은 것으로 보자.
간선은 항상 두 정점을 잇는다. 앞으로 정점은 번호로(1번 정점, 2번 정점), 간선은 양 끝 정점의 번호로(1-3, 3-2) 적는다.
그래프의 간선에는 가중치가 있기도 하다. 특별한 언급이 없다면 모든 간선의 가중치가 1인 그래프로 보면 되고, 가중치가 있다면, 예를 들어 1-3 간선의 가중치가 3이라면 1번 정점에서 3번 정점으로 가기 위해 길이가 3인 간선을 지나야 한다고 말한다. 위 그래프는 모든 간선의 길이가 1인 예다.
그래프의 간선에는 방향이 있기도 하다. 예를 들어 1번과 3번 정점 사이에 놓인 1-3 간선은 1에서 3으로, 또는 3에서 1로 향하는 방향을 가질 수 있다. 방향이 있는 간선을 가진 그래프를 유향 그래프, 위 그림처럼 방향이 없는 간선만으로 이루어진 그래프를 무향 그래프라 한다. 간선의 방향은 그래프에서 탐색을 진행할 때 결과를 바꾸어 놓는다. 예를 들어 지금 위 그래프에서 1번 정점부터 4번 정점까지 가면서 간선을 가장 적게 거치는 경로는 1, 3, 4 순서로 간선 2개를 거친다. 우리는 이것을 1번 정점과 4번 정점의 최단 경로는 2라고 말한다. 하지만 3번 정점과 4번 정점 사이의 간선이 4에서 3으로 향하는 방향을 가진다면, 1번 정점에서 4번 정점으로 가는 최단 경로는 1, 3, 6, 5, 4 순서로 간선 4개를 지나야 한다. 즉, 최단 경로가 4가 된다.
그래프에서는 사이클을 정의한다. 무향 그래프의 사이클은 어떤 정점에서 출발해 시작점을 뺀 어떤 정점도, 어떤 간선도 두 번 이상 방문하지 않고 시작점으로 돌아오는 경로다. 예를 들어 위 그림에는 3-6-5-4-3 사이클과 6-7-9 사이클이 있다. 1-3-1은 1-3 간선을 두 번 지났으므로 사이클이 되지 못하고, 1-3-6-5-4-3은 시작점으로 돌아오지 않는 경로이므로 사이클이 아니다.
그래프에 사이클이 단 하나도 없다면 그 그래프를 트리라고 부른다. 그래프가 마치 한 정점에서 출발해 피어난 나무 모양과 같아서 붙은 이름이다. 예를 들어 위 그림에서 붉은 간선 두 개를 지우면 그래프는 트리가 된다. 위에 주어진 그래프에서 붉은 간선 두 개를 지운 뒤 만들어진 트리의 모습은 아래와 같다.
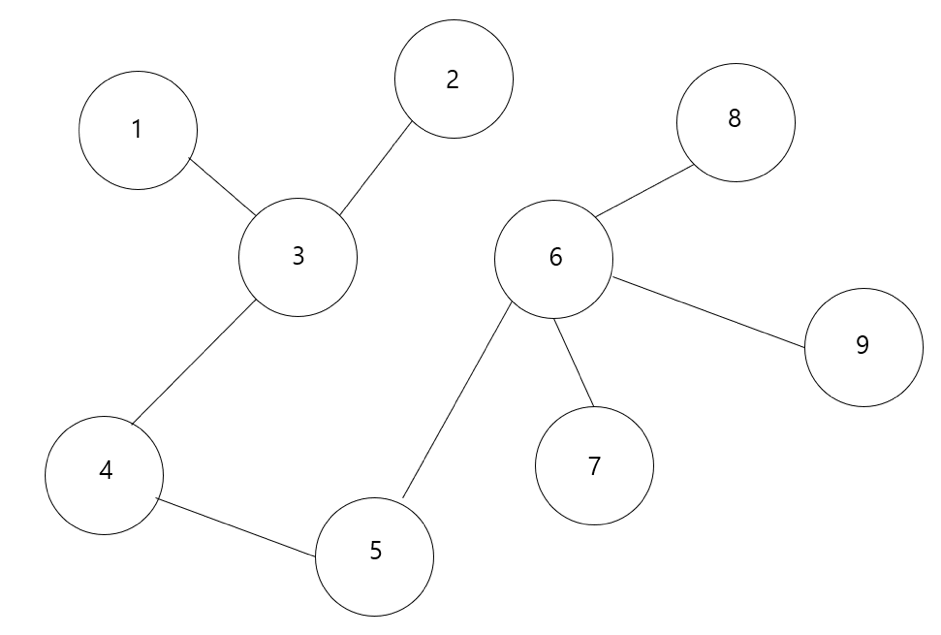
그래프에서는 정점의 위치나 간선의 모양을 전혀 따지지 않고 연결 관계만 따지므로, 간선의 집합이 변하지 않는다는 가정 아래 그래프를 얼마든지 다시 그린다. 위 트리에서 5번 정점을 잡고 위로 들어올리는 예를 생각해 보자. 아래쪽에 중력이 작용한다고 보고 5번 정점을 위로 들어올리면 트리의 모양은 아래와 같이 바뀐다.
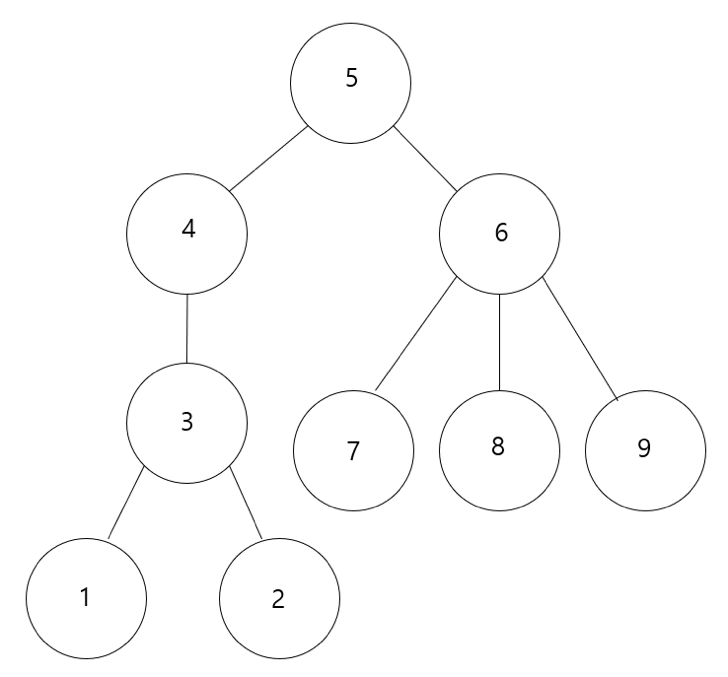
간선의 집합에 변함이 없는 한 그래프는 얼마든지 원하는 대로 다시 그린다. 예를 들어 위 트리를 거울에 비추어 좌우를 바꾸어도 같은 트리다.
트리에는 루트가 있기도 하고 없기도 하지만, 편의를 위해서라면 아무 정점이나 루트로 고를 수 있다. 5번 정점을 루트로 삼았다고 생각하고 위 트리를 다시 보자.
트리는 항상 루트를 기준으로 다시 그릴 수 있기 때문에, 루트가 고정되지 않는 한 어떤 정점이 위에 있는지 판정하지 못한다. 하지만 루트가 고정된다면 정점 사이에 부모와 자식 관계를 정의한다. 예를 들어 위 트리에서 4번 정점의 부모는 5번 정점이고, 3번 정점은 4번 정점의 자식이다. 5번 정점은 부모가 없고, 4번과 6번 정점을 두 자식으로 둔다.
트리에는 중요한 성질이 몇 가지 있는데, 그중 두 가지만 추리면 아래와 같다.
- 임의의 두 정점 와 에 대해 에서 로 가는 최단 경로는 유일하다.
- 아무 정점이나 잡고 부모와의 연결을 끊었을 때, 그 정점과 그 자식, 그 자식의 자식으로 이어지는 부분그래프는 트리가 된다.
둘 모두 직관적이고 자명한 사실이므로 증명은 생략한다. 두 번째 성질에서 끊어진 부분그래프로 만들어진 트리를 서브트리라고 부른다.
트리에 대한 문제 하나가 출제되었다고 가정해 보자. 입력이 위처럼 루트와 그 자식으로 이루어진다면 좋지만, 루트가 없는 일반 트리의 형태(두 번째 그림)로 입력이 주어지기도 한다. 예를 들어 정점의 개수와 간선의 목록만 주어진다면 트리를 어떻게 구성할까?
위 트리에 대해 정점의 개수와 간선의 목록이 아래와 같이 입력된다고 하자.
9
1 3
4 3
5 4
5 6
6 7
2 3
9 6
6 8
첫 줄의 9는 정점의 개수이고, 나머지 8쌍의 두 정수는 간선의 양 끝점 번호다. 트리의 간선 개수가 항상 정점 수에서 1을 뺀 값이라는 사실은 익히 알려져 있고 증명 또한 어렵지 않으므로 설명을 생략한다.
이런 데이터를 트리로 구성하려면 우선 루트 하나를 임의로 정하는 편이 편하다. 5번 정점을 루트로 정해 보자.
트리에는 부모와 자식 관계가 있으므로, 정점마다 부모가 누구인지와 자식의 목록이 어떻게 되는지를 저장해 두면 요긴하게 쓰인다. 이를 아래와 같이 구현한다.
def makeTree(currentNode, parent):
    for Node in connect[currentNode]:
        if Node != parent:
            add Node to currentNode's child
            set Node's parent to currentNode
            makeTree(Node, currentNode)
currentNode는 지금 탐색 중인 정점이고, parent는 그 정점의 부모 정점이다.
트리에서 어떤 정점의 부모는 하나이거나 없다. 따라서 어떤 정점에 연결된 모든 정점은 많아야 한 개를 빼면 모두 그 정점의 자식이 된다. 이에 따라 부모 정점의 정보를 넘겨 가면서, 부모 정점이 아니면서 자신과 연결된 정점을 모두 자신의 자식으로 삼고, 자신의 자식이 될 정점의 부모 정점을 자신으로 연결한 뒤, 자식 정점에게 트리 구성을 재귀로 맡기는 형태의 함수다.
위와 같이 정의한 뒤 메인 함수에서 makeTree(5, -1)을 한 차례 호출하면 5번 정점을 루트로 하는 트리를 구성한다. -1은 부모가 없음을 뜻한다.
그렇다면 일반적인 형태의 트리에 루트가 주어진 뒤 질의가 여럿 주어지는 상황을 생각해 보자. 예를 들어 5번 정점을 루트로 하는 트리에 대해, 정점 를 루트로 하는 서브트리의 정점 수는 얼마인가라는 질의가 여러 번 주어진다고 해 보자. 를 루트로 하는 서브트리란, 위에서도 말했듯 정점 와 그 부모의 연결을 끊고 정점 를 기준으로 그 자식, 그 자식의 자식으로 만든 트리를 말한다. 예를 들어 5번 정점이 루트일 때 4번 정점을 루트로 하는 서브트리의 정점 수는 4개이고, 8번 정점을 루트로 하는 서브트리의 정점 수는 1개가 된다.
물론 질의마다 직접 연결을 끊은 뒤 다시 정점 수를 세는 방법도 되겠지만, 트리의 정점 수가 많고 질의 또한 많다면 프로그램이 제한 시간 안에 수행되지 못할 확률이 높다. 아마 모든 정점을 각각 루트로 하는 서브트리의 정점 수를 미리 빠르게 구해 둘 방법이 있다면 좋을 것이다.
이를 구현하기 위해 트리를 구성하던 코드의 동작 과정을 살펴보자. 루트에서 출발해 자식 정점마다 한 번씩 트리 구성을 맡긴다. 여기에서 알 수 있는 사실은, 자식 정점에 대한 makeTree 호출이 끝나면 그 자식 정점을 루트로 하는 서브트리의 구성이 끝난다는 것이다. 이와 같은 원리로 모든 정점에 대해 그 정점을 루트로 하는 서브트리에 속한 정점의 수를 계산하는 함수를 만들어 보자.
def countSubtreeNodes(currentNode):
    size[currentNode] = 1
    for Node in currentNode's child:
        countSubtreeNodes(Node)
        size[currentNode] += size[Node]
자신도 자신을 루트로 하는 서브트리에 포함되므로 크기는 0이 아니라 1에서 시작한다. 자식 정점에 대해 서브트리에 속한 정점의 수를 모두 계산하게 만든 뒤 각각의 정점 수를 더해 자신을 루트로 하는 서브트리에 속한 정점의 수를 만든다. 이제 메인 함수에서 makeTree(5, -1)과 countSubtreeNodes(5)를 차례대로 한 번씩 호출하면, 5번을 루트로 하는 트리의 모든 정점에 대해 각 정점을 루트로 하는 서브트리에 속한 정점의 수를 미리 계산해 둘 수 있다. 이를 쓰면 모든 질의 에 대해 size[U]를 출력하기만 하면 되므로, 정점이 10만 개이고 질의가 10만 개인 데이터에서도 모든 질의를 충분히 빠른 시간 안에 처리한다.